1. Корень
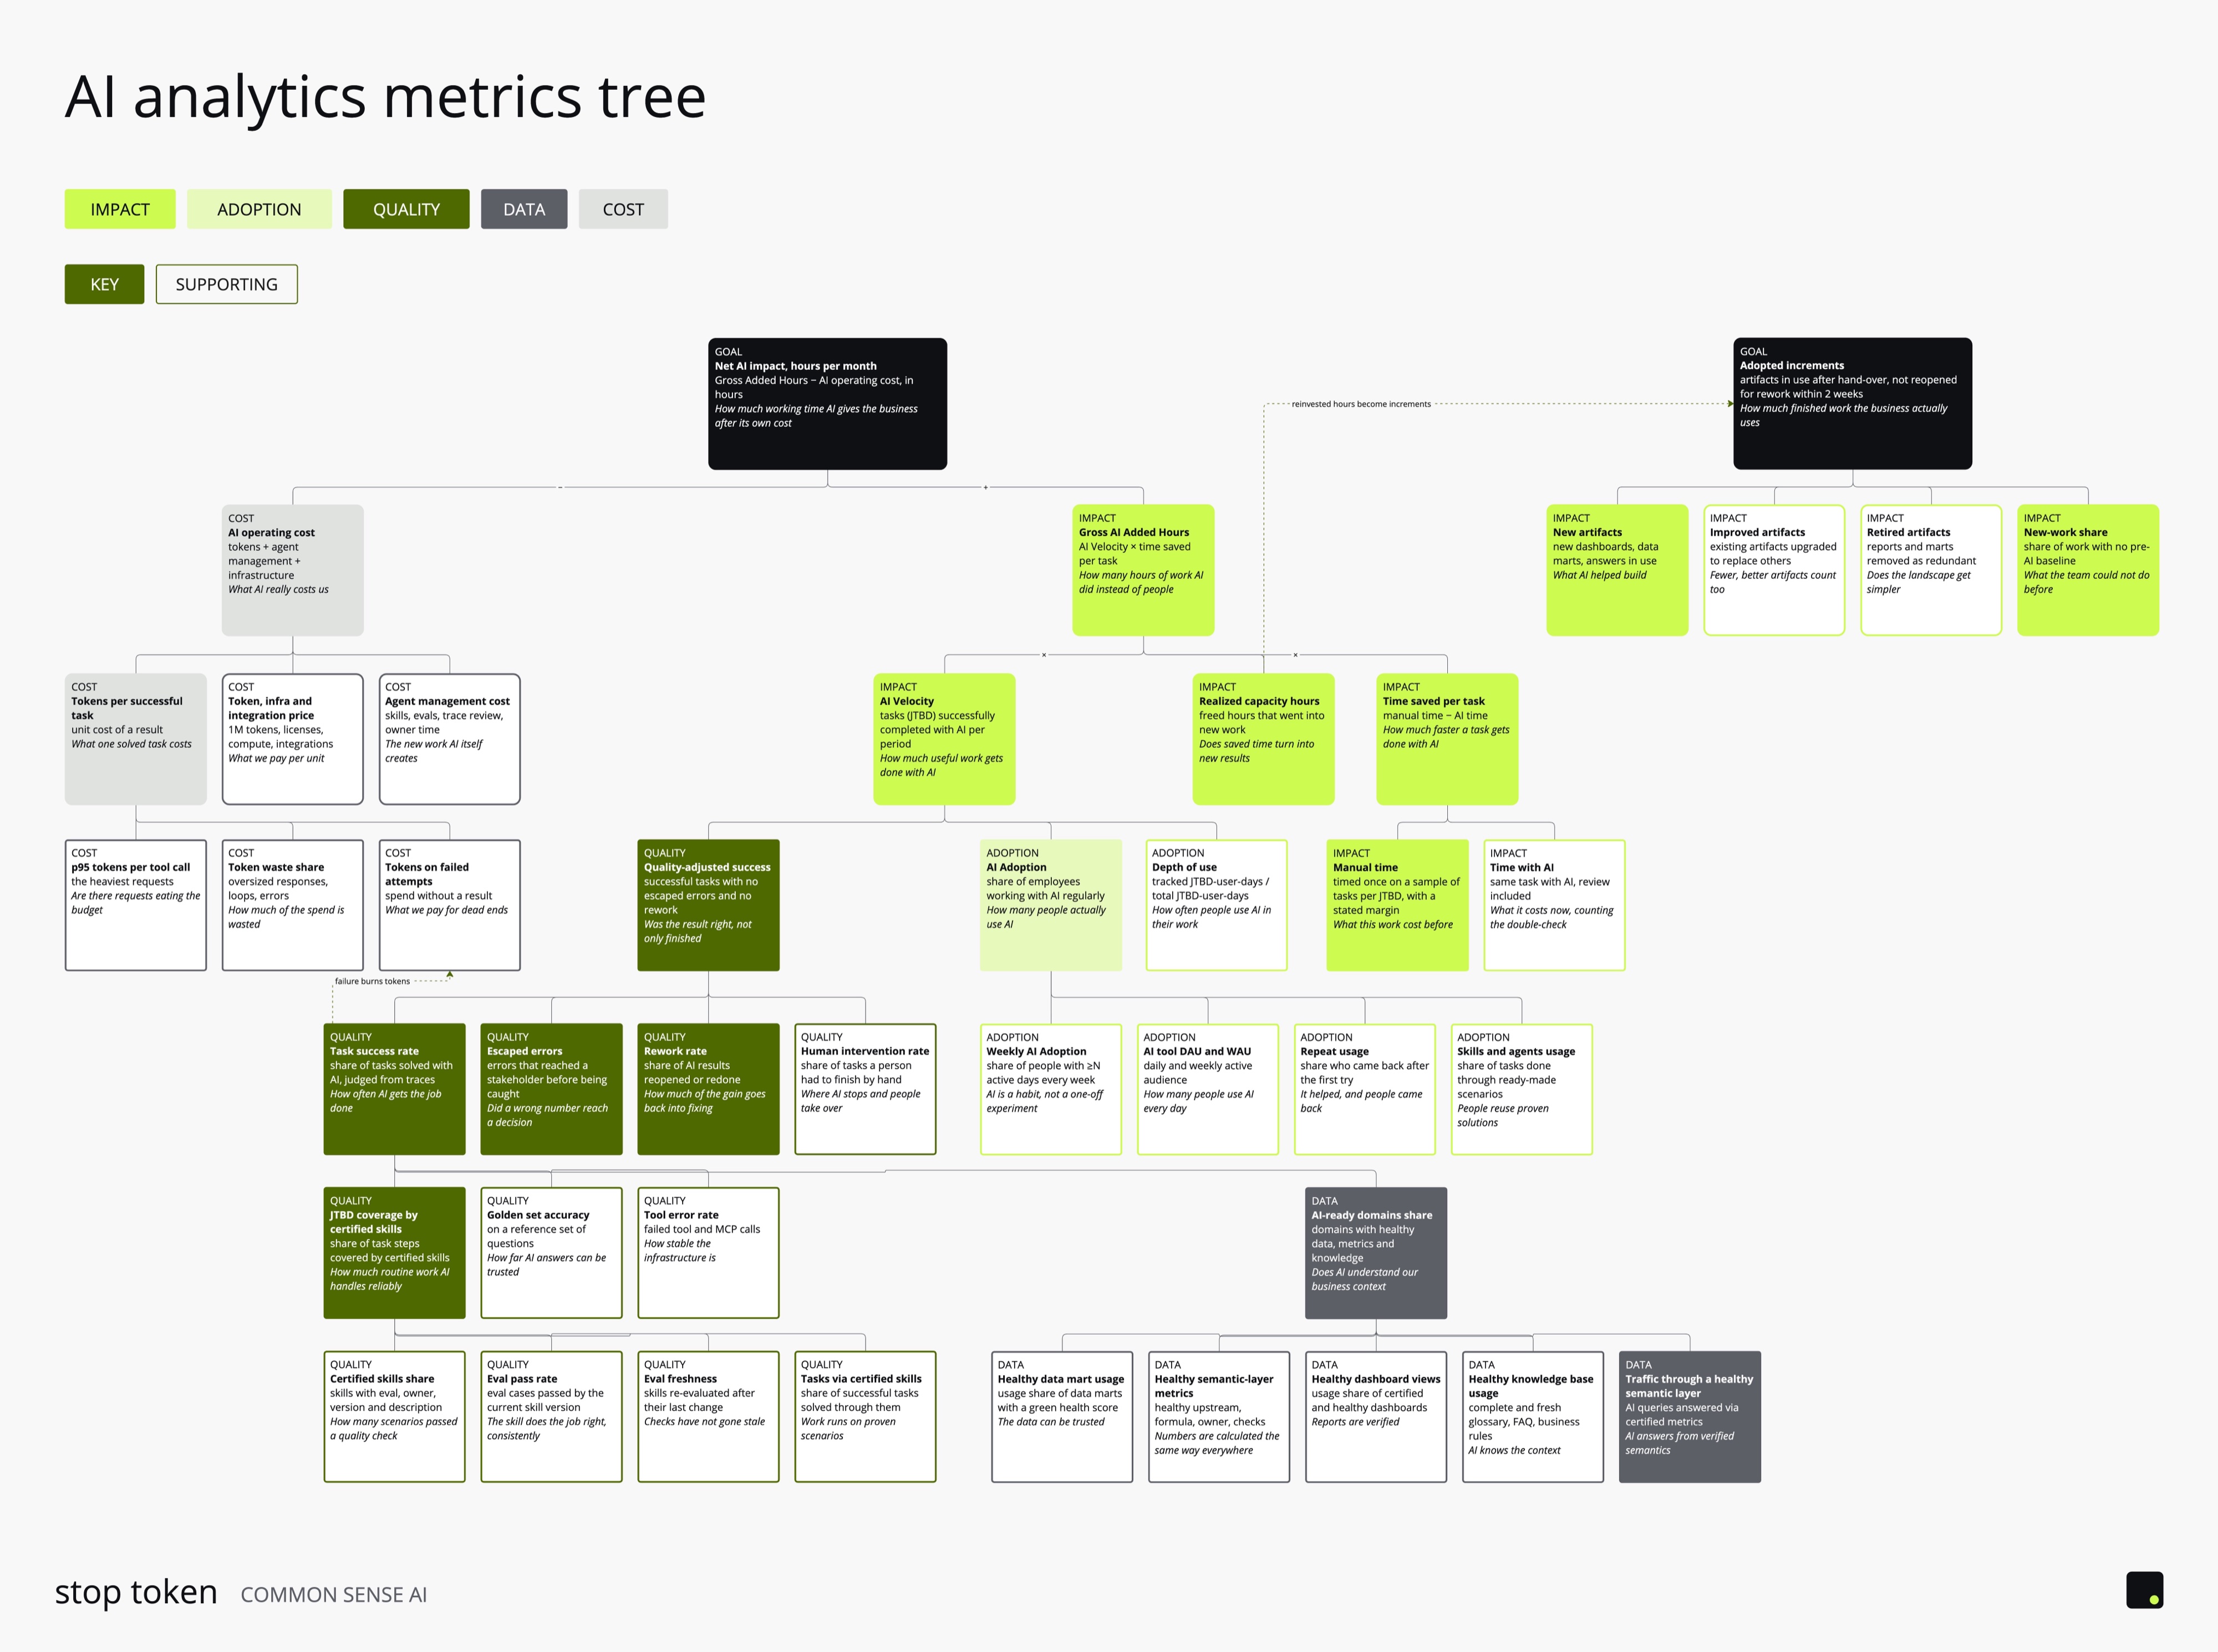
Наверху одна метрика — сколько часов в месяц AI добавляет за вычетом своей стоимости.
Net Added Hours = Gross Added Hours − AI operating cost в пересчёте на часы
Gross Added Hours = AI Velocity × экономия времени на задачу
- AI Velocity — число задач, успешно решённых с AI за период;
- экономия на задачу — ручное время минус время с AI, включая проверку.
На первой же итерации такая метрика упирается в чувствительную тему. FTE подталкивает к разговору о сокращении ставок, к которому цифры не готовы. «Намайненные» часы ещё не высвобожденные ставки.
Отдельная ветка — Realized capacity hours, часы, которые ушли в новую работу. Вопрос в том, как считать реинвестированное время. Хорошего ответа нет.
Ручное время на типовые задачи (JTBD, job-to-be-done) почти никто не мерил, есть только экспертные оценки. Без этого замера Added Hours остаётся грубой величиной. Мой рабочий ответ: один раз замерить небольшую выборку повторяющихся задач каждого типа и указать погрешность.
2. AI Velocity
Раскладываю на три части:
- AI Adoption — доля людей, которые пользуются AI регулярно (≥N активных дней в каждой неделе);
- задачи на активного пользователя;
- Quality-adjusted success — доля задач, доведённых до верного результата.
Успешность по трейсам говорит, что задача завершена. Верный ли ответ, она не говорит. Поэтому над success rate стоит слой качества: задачи без ошибок, дошедших до заказчика, и без переделок. Рядом с success rate ещё три метрики: ошибки, дошедшие до заказчика, доля результатов, которые пришлось переделывать, и доля задач, которые человек доделал руками.
Почти у всех есть дашборды по AI adoption: DAU, WAU, число вызовов, токены. И эти цифры растут. Ответить по ним, сколько времени или денег AI дал бизнесу, нельзя. По опыту, бизнес это долго устраивать не будет.
С BI было похоже: просмотры дашбордов долго считали успехом. Здесь, в отличие от дешей, можно увидеть задачи, которые решают в сессиях, и оценить их успешность. Оставим adoption в дереве и идём дальше.
Первые две части растут от обучения, промо, хакатонов. Success rate зависит от качества скиллов, инструментов и данных. Если поднимать охват при низком success rate, вместе с ним растёт объём переделок.
3. Покрытие JTBD сертифицированными скиллами
Скилл агента требует того же гавернанса, что витрина или дашборд: владелец, версия, проверки, описание. Метрика покрытия — доля шагов типовых задач, закрытых сертифицированным скиллом. Сертифицированный значит:
- есть eval-набор, владелец, версия, описание;
- текущая версия проходит eval (pass rate);
- eval прогоняли после последнего изменения скилла (freshness).
Рядом нужна доля успешных задач, которые прошли через сертифицированные скиллы. Иначе получится каталог, которым не пользуются. С каталогами данных так уже было.
В эту же ветку — точность на golden set и доля ошибок инструментов. Если MCP-ручка падает в заметной доле вызовов, success rate упирается в инфраструктуру.
4. Данные
Text-to-SQL без понимания домена работает плохо, это подтвердил и разбор Anthropic. Ветка AI-ready доменов — про то, на каких данных агент отвечает:
- доля использования витрин с зелёным health score (свежесть, DQ, владелец, описание);
- доля метрик семантического слоя со здоровым апстримом, формулой, владельцем и проверками;
- доля просмотров сертифицированных и здоровых дашбордов;
- доля использования полного и актуального контекста: глоссарий, FAQ, бизнес-правила.
Первой смотрю долю AI-запросов, на которые ответ пришёл через сертифицированные метрики семантического слоя. Когда агент каждый раз пишет SQL по сырым таблицам, это дороже и чаще даёт правдоподобные ошибки.
Все метрики этой ветки пока про покрытие. Как отличить полезный контекст от балласта и рабочий eval от формального, не знаю. Рассчитываю на трейсы и golden sets.
5. Затраты
Токены — только видимая часть затрат. Ветка называется AI operating cost: токены, работа по сопровождению агентов (скиллы, eval-наборы, разбор трейсов, время владельцев) и цена инфраструктуры и интеграций. Сопровождение агентов — новая работа, которой до AI не было, и ей место в затратах.
Токены считаю на успешную задачу. Общий объём растёт вместе с adoption и сам по себе мало что говорит.
- токены на успешную задачу;
- p95 токенов на вызов инструмента, чтобы найти ручки, которые тащат в контекст слишком много;
- доля waste: широкие ответы, циклы, ошибки;
- токены на неуспешные попытки.
Неуспешные попытки связывают ветки: при низком success rate меньше часов наверху и больше затрат внизу.
Снижение токенов тоже может быть проблемой. Если агент недобрал данных и человек дособрал ответ руками, затраты переехали в другую ветку.
6. Вторая цель: принятый инкремент
Рядом с Net Added Hours в дереве вторая цель — Adopted increments: рабочие артефакты, которыми пользуются после сдачи и которые две недели не возвращали на переделку. Дашборды, витрины, ответы на вопросы бизнеса.
Цели связаны между собой: сэкономленные часы ценны, если реинвестированы в новую работу. Adopted increments показывает, случилось ли это.
Вероятно, это самый справедливый показатель из всего дерева. Он не требует знать ручное время до AI, не зависит от того, кто дотащил задачу — AI или человек, и не путается с сокращением ставок. Считается результат, который получил бизнес.
Раскладывается на четыре части:
- новые артефакты, которыми пользуются;
- улучшенные артефакты: доработанный дашборд, который заменил три отчёта, тоже считается;
- выведенные артефакты: отчёты и витрины, удалённые как лишние;
- доля новой работы: то, чего не было до AI и что команда раньше не могла сделать.
Слабые места остаются. Артефакты разного размера, и складывать дашборд с ответом в чате некорректно. AI делает новый дашборд дешевле, а нужных от этого больше не становится. Счёт только используемых артефактов с правилом двух недель убирает большую часть мусора.
7. Ключевые и второстепенные метрики
На картинке залитые карточки — ключевые метрики, белые — второстепенные. Начинать стоит с ключевых. Второстепенные объясняют, почему ключевая сдвинулась.
Что не решено
- Замер ручного времени. Без него Added Hours — грубая оценка.
- Классификация задач. Чтобы считать velocity по JTBD, нужно сопоставлять запросы к AI с типами JTBD. По детальным логам это дорого и упирается в доступ к трейсам, по вызовам MCP получается слишком грубо.
- Успешность. Разметка AI-судьями показывает среднюю точность. Часто непонятно, как отделить задачи, которые AI решил в сессии, от задач, которые человек потом дотащил сам или в итоге бросил.
- Качество решений. Дерево меряет работу аналитики. Стали ли решения лучше, в нём пока нет. Ближайший практичный шаг — журнал решений: к какому действию привёл анализ и на каких допущениях.
Если AI станет частью всех процессов, сравнение «с AI и без» может потерять смысл, и останутся velocity и принятый инкремент. Насколько это хорошо, не знаю.
Если считаете эффект AI у себя — напишите, где ваше дерево устроено иначе. Особенно интересно, как вы мерили ручное время.