Почему мы до сих пор прогоняем данные через столько слоёв, только чтобы по ним можно было делать запросы?
Мы их загружаем, трансформируем, копируем в следующий слой, агрегируем и строим поверх ещё один слой для выдачи. У многого в этой архитектуре есть причины: дашбордам нужно предсказуемое время ответа, аналитические запросы не должны нагружать прод, а бизнесу нужны стабильные выверенные датасеты. Но не каждый слой окупает свою стоимость.
Что меняется, когда потребитель — AI-агент? Агент, который сам находит данные, пишет SQL, соединяет источники и разбирается в вопросе шаг за шагом.
Мой рабочий ответ: меньше, чем утверждают сторонники «хранилище умерло», и больше, чем думают сторонники «просто прикрутите к хранилищу чат». Физические слои могут стать тоньше. Слой, который держит смысл и контроль, должен стать намного сильнее. И может поменяться порядок проектирования: вместо того чтобы заранее решать, какие определения и короткие пути построить, можно по реальным вопросам увидеть, чего платформе не хватает.
Зачем на самом деле было нужно хранилище
Хочется сказать, что хранилища существуют ради скорости дашбордов. Это только часть истории.
Билл Инмон определял хранилище данных как предметно-ориентированное, интегрированное, привязанное ко времени и неизменяемое. Посмотрите на два последних свойства. Системы-источники чаще всего не обладают ни тем, ни другим: CRM перезаписывает сегмент клиента, биллинг меняет статус подписки на месте. Если предыдущее состояние никто не сохранил, никакой, даже самый умный, движок запросов не скажет, что было правдой полгода назад.
Хранилище делает и работу, о которой редко вспоминают:
Изоляция
Аналитические запросы не идут в продовые базы.
Интеграция
Кто-то установил, что клиент 4812 в CRM и аккаунт A-77 в биллинге — одна и та же сущность.
Стабильность
Когда источник переименовывает колонку, изменение поглощается в одном пайплайне, а не в каждом отчёте.
Ничто из этого не исчезает оттого, что потребитель — агент. Любая честная версия «запросов на месте» должна сказать, где вместо хранилища живут история, изоляция и интеграция.
Открытые форматы таблиц — это не федерация
В аргументах «хватит копировать данные» часто смешиваются две разные идеи.
Открытые форматы таблиц
Apache Iceberg и Delta Lake отделяют метаданные и хранение таблиц от движка запросов. Данные загружаются в открытом формате, и несколько движков читают одни и те же управляемые таблицы. Это может убрать необходимость держать отдельную проприетарную копию хранилища под каждый движок. Это всё ещё копия данных источника, но она может быть стабильной, изолированной и версионируемой аналитической копией, а не ещё одним проприетарным слоем выдачи.
Федерация
Движки вроде Trino делают запросы к нескольким системам через коннекторы, не копируя сначала каждый источник в центральное хранилище. Насколько хорошо это работает, зависит от плана выполнения. Какие фильтры, агрегаты и join можно спустить в источник (pushdown), зависит от коннектора и операции. Если операцию спустить нельзя, данные всё равно поедут по сети, только во время запроса, а не во время загрузки.
Компромиссы разные. Открытый lakehouse даёт управляемую аналитическую среду, где историю и изоляцию можно заложить в дизайн. Федерация может дать более свежие данные и обойтись без загрузки, но наследует ограничения источника и усложняет согласованность между источниками и производительность.
Для агентной аналитики я бы сделал lakehouse средой выполнения по умолчанию: данные приземляются в открытом формате, изолированно от прода, с историей и версиями там, где они нужны. Федерацию использовать выборочно, когда важна свежесть, объём запрашиваемых данных достаточно мал и план выполнения работает эффективно. Материализованные таблицы добавлять, когда их оправдывает измеренная нагрузка.
Речь не о «нуле копий». Речь о меньшем числе обязательных слоёв по умолчанию.
Разве lakehouse — это не та же централизация данных? Отчасти да, и это стоит признать. Но это одна открытая копия, которую читают многие движки, а не цепочка проприетарных слоёв выдачи. И это вариант по умолчанию для данных, с которыми работают агенты, а не правило для каждого источника. А вот что централизовать нужно без исключений, так это смысл и политики.
Мы это уже проходили: виртуализация данных
«Делать запросы к данным там, где они лежат» — не новая идея. Вендоры виртуализации данных больше десяти лет обещают логический слой поверх многих источников: одно место, где определяются бизнес-представления, меньше ETL и меньше копий.
Она упёрлась в реальные ограничения:
- Join между источниками мог тянуть по сети большие объёмы данных.
- Аналитические запросы могли перегружать операционные системы.
- Не было согласованного снимка по несвязанным источникам: две системы, опрошенные с разницей в секунды, могли расходиться.
- BI-дашбордам часто нужна была предсказуемая низкая задержка.
Зрелые платформы виртуализации ответили кэшированием, предагрегированными сводками и ускорением запросов. Виртуализация буксовала не потому, что никто не додумался до материализации. Она упёрлась в физику: аналитическую нагрузку обслуживали операционные системы.
Часть ограничений теперь проще обойти. «На месте» может значить в изолированном озере, а не в продовой базе. Снимки открытых таблиц позволяют привязать чтение к конкретной версии, если эти снимки хранятся. Эластичные вычисления делают часть запросов по требованию практичными. А некоторые агентные задачи — фоновые расследования или плановые анализы — могут обменять задержку на гибкость так, как интерактивный дашборд не может.
Другие ограничения остаются. Если источники перезаписывают состояние, историю всё равно нужно сохранять через CDC или снимки. Снимок одной таблицы в озере не даёт согласованного снимка по несвязанным живым источникам. Свободные исследовательские join не должны идти в продовые OLTP-системы. Сопоставление сущностей между системами — по-прежнему настоящая инженерная работа. И задержки складываются: десять последовательных запросов по 20 секунд — это долгое ожидание в живом разговоре.
Возможность здесь не в том, чтобы сделать виртуализацию лучше. Виртуализация показывала операционные системы BI-инструментам как одну базу. Платформа, готовая к агентам, даёт управляемую среду потребителям, которые сами формулируют запросы. И может использовать то, что эти запросы показывают, чтобы улучшать саму платформу.
Агенты поднимают планку для смысла
Агенты умеют смотреть схемы и писать SQL, но это не значит, что они знают, что данные означают.
Типичный сбой выглядит так. Агента просят посчитать выручку за прошлый месяц. Он находит таблицу payments с полями payment_id, amount, status и created_at, фильтрует по месяцу и суммирует amount.
SQL корректный, число выглядит правдоподобно. Но таблица — журнал изменений: каждый платёж встречается по разу на каждое изменение статуса (создан, авторизован, списан, иногда возвращён). Большинство платежей посчитаны трижды, а возвраты посчитаны как выручка.
Мог бы внимательный агент это заметить? Возможно. Он мог бы проверить, уникален ли payment_id, и разобраться с дублями. Но потом ему всё равно нужно решить, какой статус считается выручкой, вычитаются ли возвраты, исключаются ли тестовые аккаунты и в каком часовом поясе считается «прошлый месяц». Ничего из этого нет в схеме. Это бизнес-решения.
Задайте тот же вопрос дважды или двум агентам — и можно получить разные числа, каждое с безупречно корректным SQL.
Это проблема информации, а не рассуждения, которую надёжно решит более умная модель. Аналитики-люди тоже с ней сталкиваются, но у них есть контекст, прошлые проверки, ревьюеры и общие договорённости. У агента, который выдаёт ответы в масштабе, ничего этого нет, если платформа этого не даёт.
Каноническое определение выручки может предотвратить именно этот сбой, но только если его проверяют на данных и синхронизируют с изменениями источника. Семантика не убирает проблему в целом, она её переносит. Определения покрывают вопросы, которые кто-то предвидел, а агенты полезнее всего как раз там, где никто не предвидел. На таких вопросах агент снова оказывается перед сырыми таблицами. Поэтому семантика должна описывать данные, а не только метрики: гранулярность, ключи, значение статусов, исключения и связи между сущностями. А ответы должны показывать, на канонических ли определениях они построены или на логике, которую агент придумал сам.
Интеграция и история у Инмона, согласованные измерения и объявленная гранулярность у Кимбалла по-прежнему важны. Их подходы к построению хранилища различались, но ни один из этих принципов не требует, чтобы каждый аналитический запрос выполнялся в одной физически централизованной системе.
Контроль, выполнение, доказательства
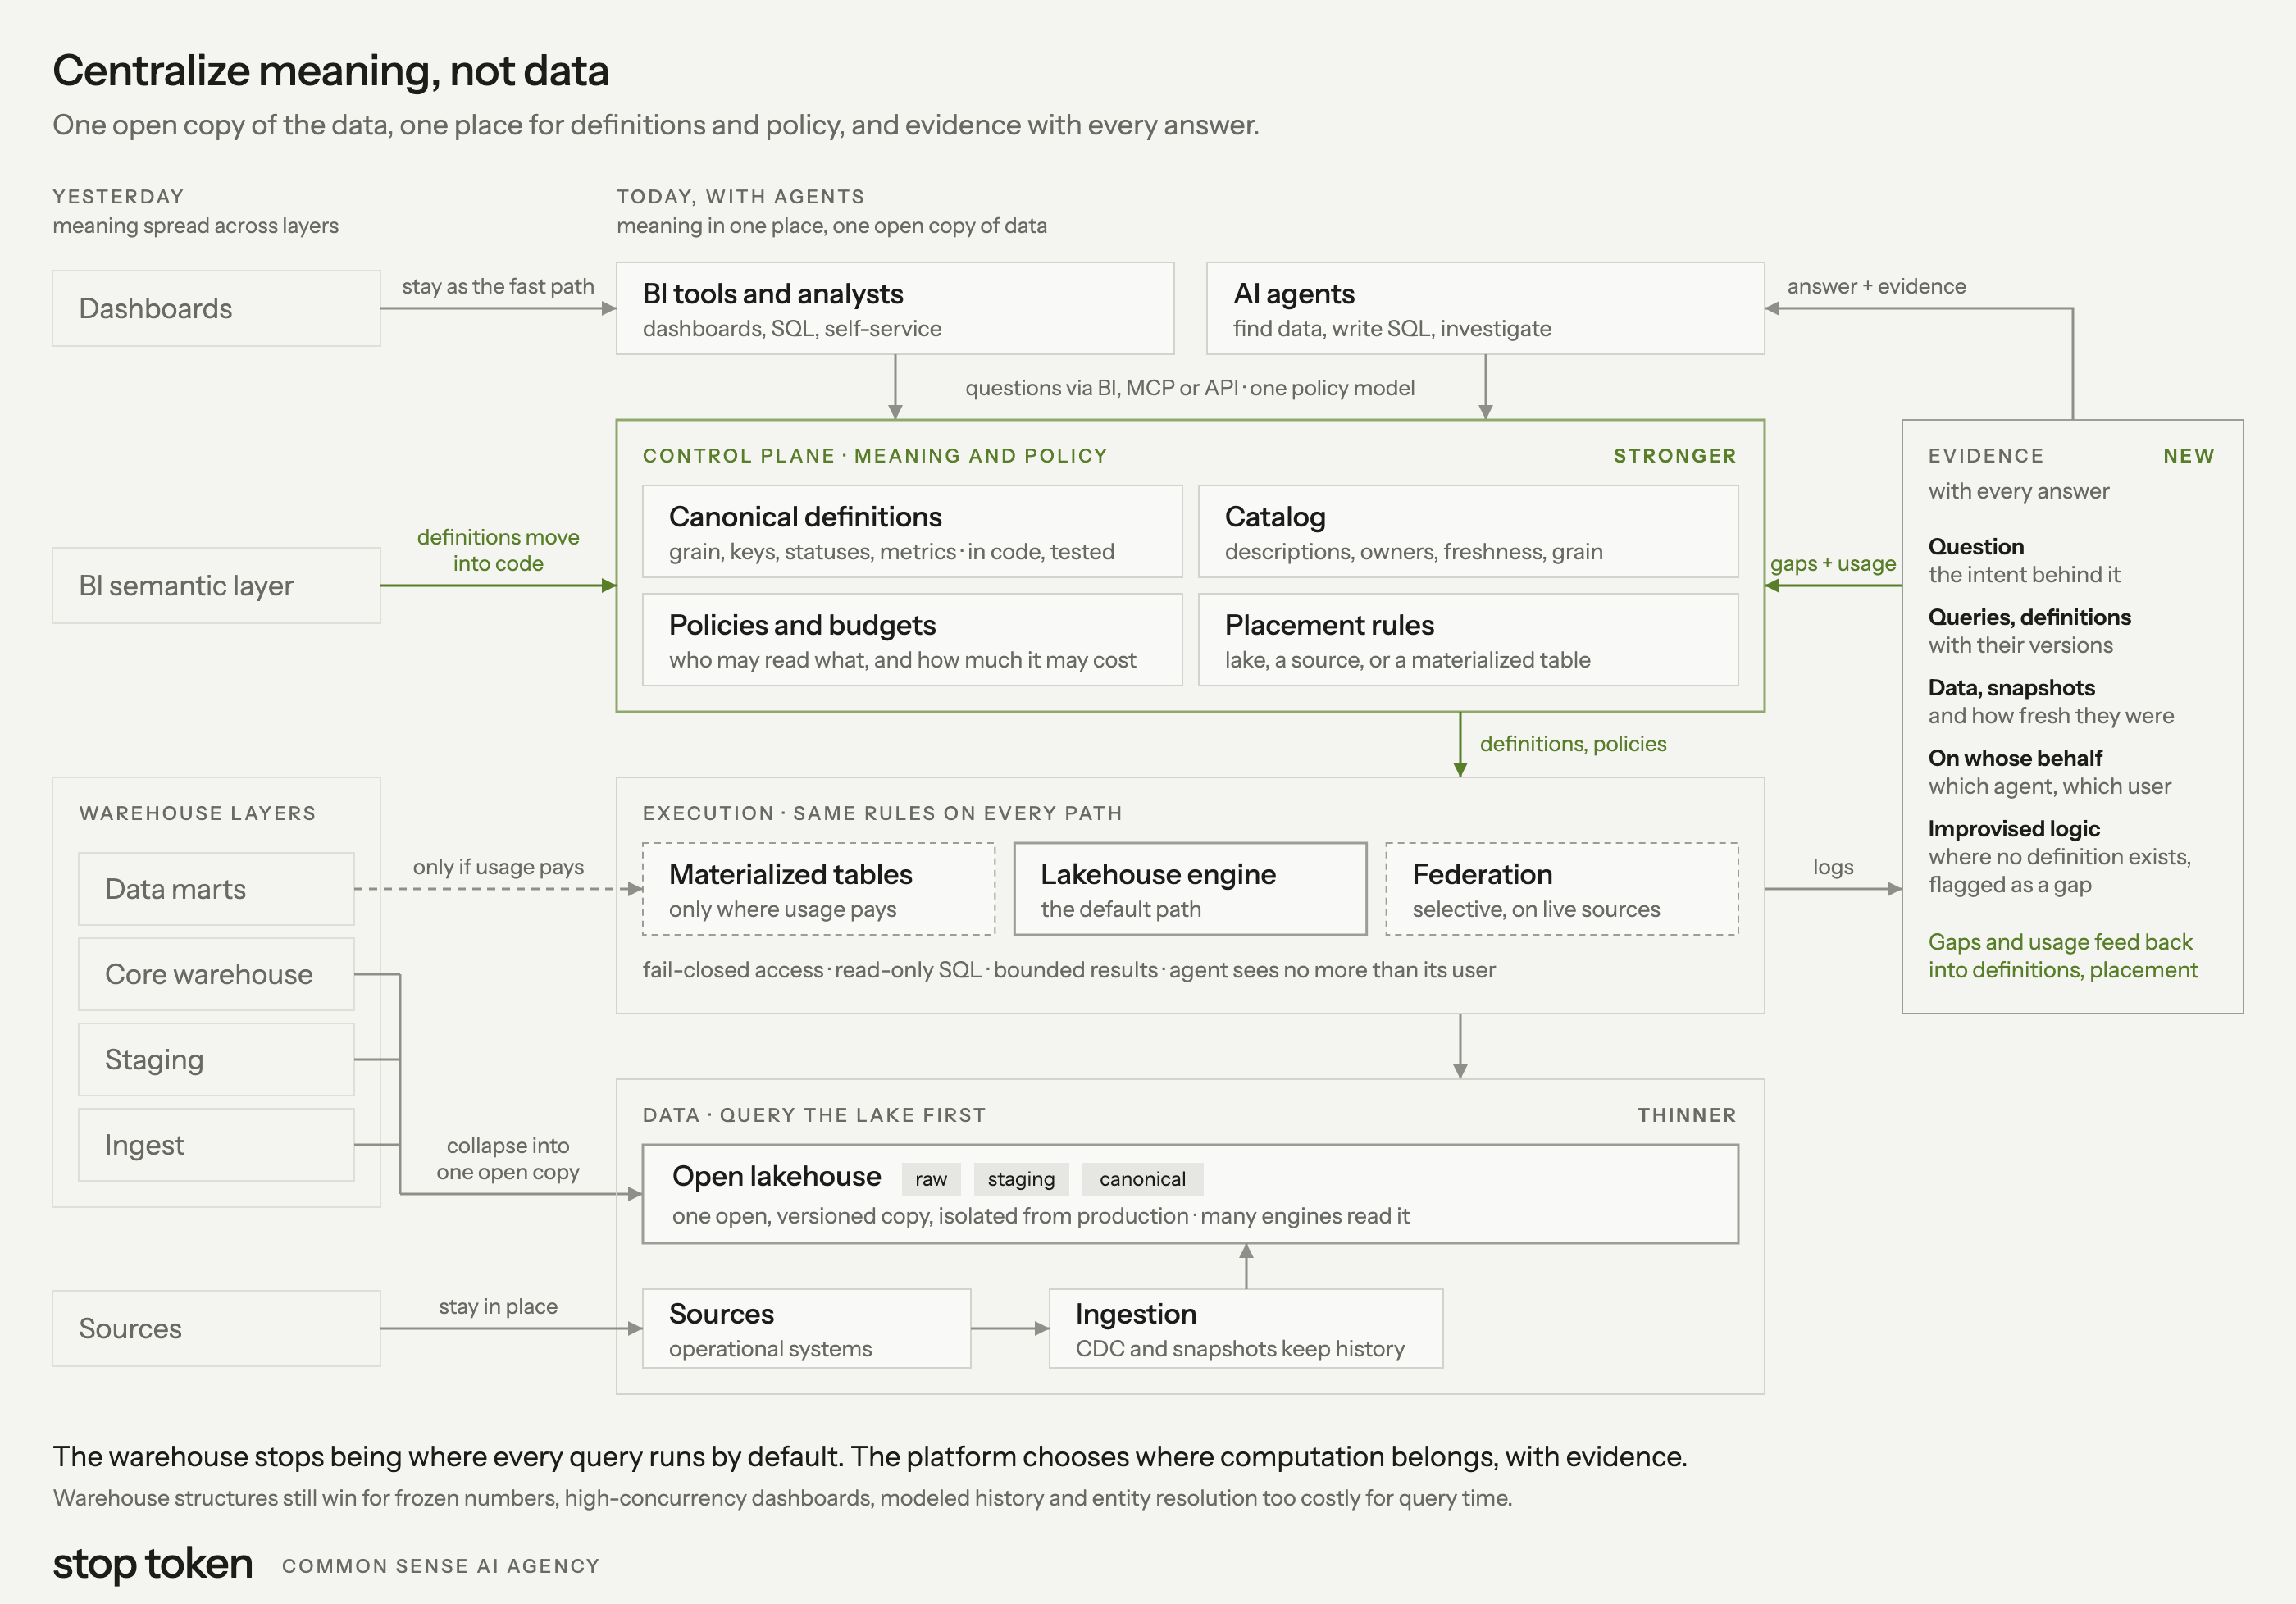
А что, если ядро следующей платформы данных — не хранилище, а control plane вокруг него?
Термин требует точности. Control plane решает и настраивает, execution plane выполняет работу. Для платформы, готовой к агентам, я бы разделил три зоны ответственности:
Control plane:
каталог, канонические определения, политики доступа, бюджеты и правила, где должны выполняться вычисления.
Execution plane:
движки запросов, федерация и pushdown, кэши и материализованные таблицы. Он применяет политики control plane, но не владеет ими.
Слой доказательств:
записывает, как получен ответ, чтобы его можно было отследить и, если позволяют входные данные, воспроизвести.
Это не три новых продукта. Это зоны ответственности, которые должны закрыть существующие компоненты. Смысл в том, чтобы централизовать политики, а не обязательно прогонять все вычисления через один центральный сервис. Каждый путь выполнения должен применять одни и те же правила.
Control plane: смысл и политики
Поиск данных
Агенту нужно найти правильные данные, прежде чем делать к ним запрос: каталог с описаниями, владельцами, свежестью, гранулярностью и связанными определениями. Без этого контекста агент может выбрать таблицу, чьё название выглядит подходящим, но строки которой — изменения статуса, а не платежи.
Канонические определения
Метрики и сущности должны быть определены один раз, в коде, с версиями и ревью: что считается «активным», как считается выручка, какая гранулярность у каждой таблицы фактов и как ключи соотносятся между системами. Определениям нужны тесты на данных, а не только ревью. Миграция, которая превращает таблицу текущего состояния в журнал изменений, может тихо сломать все построенные на ней определения.
Политики и бюджеты
Кто что может читать и от чьего имени? Сколько может потратить запрос, вопрос или агент? Агент, разбирающийся в одном вопросе, может отправить десятки запросов. Бюджеты не дают исследованию тихо стать самой дорогой нагрузкой на платформу.
Правила размещения
Где должно выполняться вычисление: в озере, спущенным в источник или по материализованной таблице? Решение зависит от планов выполнения, статистики, сетевого трафика, нагрузки на источник, свежести и стоимости. То, что федерация возможна, не делает её правильным выбором для конкретного запроса.
Execution plane: одни правила на каждом пути
Каждый запрос агента должен выполняться под одной моделью политик, через какой бы инструмент, MCP-сервер или интерфейс он ни пришёл:
Авторизация с отказом по умолчанию
Если платформа не может установить, что этот агент, действуя за этого пользователя, вправе читать таблицу, запрос отклоняется. Неизвестно — значит нет.
Проверка, что запрос только читает
Разбирать запрос парсером, а не искать шаблоны. Разрешать только чтение; отклонять DDL и DML, несколько выражений подряд и табличные функции, которые выходят за пределы управляемой среды данных.
Ограниченные результаты
Лимиты на строки и байты и таймауты не дают одному вопросу вывалить таблицу в контекстное окно.
Соблюдение бюджета
Запрос, который превысил бы бюджет, останавливается или эскалируется, а не просто логируется.
Важно, от чьего имени выполняется запрос. Частый короткий путь — сервисный аккаунт платформы с широким доступом, а права пользователей заново реализованы в платформе. Это риск confused deputy: одна ошибка в политике — и агент видит данные, которые его пользователю не положены. Где это поддерживается, делегированная идентичность позволяет источнику применять собственные права и аудировать реального пользователя, а не общий сервисный аккаунт. Действующие права должны быть пересечением того, что может видеть пользователь, и того, что разрешено агенту. Агент никогда не должен видеть больше пользователя, от имени которого действует, а часто должен видеть меньше.
Делегирование доступно не везде и должно идти через нормальный обмен токенами, а не через простую пересылку токена пользователя. Материализация это усложняет: общая таблица уже не несёт автоматически права уровня источника, поэтому равноценные политики доступа нужно сохранить или явно применить заново к материализованным данным.
Поэтому MCP — это интерфейс, а не граница безопасности. MCP стандартизирует, как агент находит и вызывает инструменты. Он не решает, что агенту можно читать, какие запросы безопасны и сколько может стоить вопрос. Если каждый MCP-сервер реализует свои проверки, у вас столько же моделей безопасности, сколько серверов, и они могут разъехаться. Модель политик должна быть общей и применяться там, где запросы реально выполняются.
Слой доказательств: отследить, повторить, воспроизвести
Ответ должен нести своё происхождение: какие данные использовал, какие определения метрик и их версии, какие запросы, какие снимки таблиц, насколько свежими были данные, какой агент действовал от чьего имени и пришло ли каждое число из канонического определения или из логики, которую агент придумал сам.
Три уровня легко спутать:
Отслеживаемость:
видно, как получен ответ. Это должно быть базовым уровнем для каждого ответа.
Повторяемость:
можно перезапустить те же запросы с теми же определениями и входными данными, если эти данные ещё доступны.
Воспроизводимость:
перезапуск даёт тот же результат. Для этого нужны версионированные определения, сохранённые снимки данных и детерминированные запросы. Федеративный запрос к живым операционным системам обычно до этой планки не дотягивает: источники могут измениться между запросами одного и того же расследования.
Для исследовательских вопросов может хватить отслеживаемости. Для финансовых и регуляторных цифр разница между повторяемостью и воспроизводимостью — это и есть вся суть. Здесь замороженные материализованные данные по-прежнему выигрывают.
Правдоподобный ответ не обязательно заслуживает доверия. Доказательства позволяют человеку или другому агенту отличить одно от другого.
Сначала семантика, потом наблюдение за нагрузкой
Эта идея кажется мне самой многообещающей, и её же я меньше всего готов назвать доказанной.
Хорошее размерное моделирование никогда не зависело от того, чтобы предсказать каждый вопрос. Подход Кимбалла начинается с моделирования бизнес-процессов на атомарной гранулярности, чтобы модель отвечала на вопросы, которые никто не предвидел. Интервью помогают решить, какие процессы моделировать первыми, а не на какие вопросы модель должна отвечать вечно. От предсказания сильнее зависело то, что мы строили сверху: агрегаты, витрины, отчёты и бизнес-определения. Одними пользуются каждый день, другие тихо гниют.
Оптимизация по фактическому использованию — тоже не новость. OLAP-движки десятилетиями предлагают проектировать агрегаты по статистике нагрузки, а советники баз данных рекомендуют материализованные представления по логам запросов. Новым может стать связь между намерением и выполнением.
Для каждого ответа агента платформа может записать вопрос на естественном языке, SQL, использованные канонические определения и логику, которую агент придумал сам. Тогда видно не только, какие запросы медленные или повторяются, но и где семантический слой не покрыл вопрос. Неудачные и брошенные вопросы тоже важны: наблюдаемая нагрузка смещена в сторону того, с чем платформа уже хорошо справляется.
Итеративный цикл может выглядеть так:
- Сначала определить базовую семантику и безопасные возможности для запросов.
- Дать платформе обслуживать реальные вопросы в изолированной аналитической среде.
- Измерять стоимость, задержку, повторы, сбои и импровизацию с семантикой.
- Улучшать определения и материализовать повторяющиеся дорогие пути, когда это оправдано экономически.
Материализация по фактическому использованию как первый шаг
Практичная первая реализация простая:
- Логировать каждый запрос со стоимостью, задержкой, использованными определениями и тем, придумывал ли агент логику сам.
- Находить повторяющиеся join и агрегации, стабильно медленные запросы и дорогие расследования.
- Предлагать материализацию с ожидаемой экономией, стоимостью обновления и последствиями для свежести; начинать с одобрения человеком.
- Регистрировать её как реализацию канонического определения, с lineage до исходных данных. Сохранять или заново применять политики доступа. Выводить из эксплуатации, когда использование больше не оправдывает стоимость.
Это процесс, а не оптимизатор. Сами по себе повторы не доказывают, что материализация окупится. Настоящее решение должно взвешивать стоимость обновления против экономии на запросах, свежесть, инвалидацию при изменении источников или определений, конкурирующую нагрузку и то, сколько запросов реально выиграет. Человек в цикле — разумная отправная точка, модель стоимости — следующий шаг.
Тот же цикл для семантики
Когда агенты раз за разом придумывают одно и то же определение, это свидетельство пробела, а не разрешение превратить самый частый ответ в бизнес-истину. Пробелы стоит приоритизировать по частоте и последствиям, а затем владельцы должны их определить и утвердить. Поскольку слой доказательств записывает, какие определения использовал каждый ответ, поиск таких пробелов становится запросом, а не ручным аудитом.
Я бы считал «сначала семантика, потом наблюдение за нагрузкой» архитектурным принципом, который нужно проверить, а не доказанной заменой традиционному моделированию. Если он подтвердится, он поменяет порядок, в котором мы развиваем платформу, но не отменит необходимость тщательно моделировать бизнес-процессы.
Когда хранилище по-прежнему выигрывает
Ничто из этого не делает классическое моделирование устаревшим. Сохраняйте или стройте структуры хранилища, когда:
- Многим пользователям нужны предсказуемые дашборды с низкой задержкой при высокой конкурентности.
- Цифры должны быть заморожены и воспроизводимы, как при закрытии финансового периода или в регуляторной отчётности.
- Историю нужно моделировать явно: медленно меняющиеся измерения, снимки или битемпоральные данные.
- Сопоставление сущностей слишком дорогое или неоднозначное, чтобы делать его во время запроса.
- Повторяющаяся нагрузка делает материализованные модели дешевле и надёжнее, чем выполнение по требованию.
Сдвиг не от хранилища к его отсутствию. Он от «хранилище — место по умолчанию, где должен выполняться каждый запрос» к «платформа выбирает, где место вычислению, и явно обосновывает этот выбор».
Если бы я начинал сегодня
Я бы начал с трёх вещей:
- По умолчанию приземлять данные, с которыми работают агенты, в изолированный открытый lakehouse; федерацию использовать выборочно, когда её оправдывают свежесть и экономика запросов.
- Определить канонические метрики, связи между сущностями и политики доступа до того, как давать агентам широкий доступ к SQL; применять одни и те же политики на каждом пути выполнения.
- Записывать намерение, запрос, определения и доказательства для каждого ответа. По этой записи находить пробелы в семантике и материализовать только ту нагрузку, которая это оправдывает.
Сложная задача переехала
Сложная задача смещается с того, куда копировать данные, на то, как дать агентам безопасно и экономно находить, запрашивать и соединять правильные данные и как учиться на вопросах, которые они задают.
Агрегаты не умерли. Инженерия данных тоже. Но поменяться может вариант по умолчанию:
Сначала запрос к озеру. Пусть использование решает, что определять и материализовать. Централизуйте смысл и контроль.
Мы проектируем следующее поколение платформ данных или автоматизируем архитектуру предыдущего?